Ik praat al ruim drie jaar met AI. Meer dan 1.500 gesprekken, verspreid over vier apps, en elke goede les verdween erin zodra ik het venster sloot. Dit project maakt van die chaos één geheugen dat ik kan doorzoeken.
Het idee komt van anderen. Andrej Karpathy schreef over het bewaren van kennis als een doorzoekbare wiki, en Charlie Hills liet zien hoe je daar met AI een tweede brein van maakt. Op die twee ideeën heb ik dit in mei 2026 gebouwd. In augustus 2026 zette Garry Tan zijn versie compleet als open bron online; daaruit heb ik per onderdeel gemeten wat er bij mijn systeem nog iets toevoegde. Het doel bleef hetzelfde: alles wat ik ooit met een AI heb besproken, terugvindbaar op één plek en samengevat tot kennis die ik hergebruik.
De aanleiding
Kennis die verdampt
In een goed AI-gesprek los je een lastig probleem op of leg je een aanpak vast die werkt. Dan sluit je het tabblad, en is het weg. De volgende keer dat je hetzelfde probleem hebt, begin je weer van voren af aan.
Bij mij speelde dat vier keer tegelijk. Ik gebruik Claude, ChatGPT, Grok en Gemini door elkaar, elk voor iets anders. Ruim drie jaar lang stapelden de gesprekken zich op in vier gescheiden apps, geen van alle fatsoenlijk doorzoekbaar, en niet één die van de andere afwist. Wat ik ooit had uitgezocht, lag verspreid over vier plekken waar ik niet bij kon.
Wat ik wilde was simpel om te omschrijven en lastig om te maken: één plek waar het allemaal samenkomt, waar ik kan terugvinden wat ik ooit heb uitgezocht, en waar terugkerende thema's samengevat worden tot kennis die ik echt hergebruik.
Ik had geen gebrek aan inzichten. Ik had gebrek aan een plek waar ze bleven.
De aanpak
Van losse chats naar een wiki
De oplossing werkt in twee lagen. De eerste laag is het ruwe archief: elk gesprek als een apart, doorzoekbaar notitiebestand. De tweede laag is de wiki: per onderwerp een samenvatting die de kern uit tientallen gesprekken destilleert. De eerste laag onthoudt alles, de tweede laag begrijpt het.
- Ophalen en opschonen. Ik exporteer de volledige geschiedenis uit elk platform en haal er automatisch persoonsgegevens en per ongeluk geplakte wachtwoorden uit voordat er iets wordt opgeslagen.
- Eén notitie per gesprek. Elk gesprek wordt een bestand met een korte samenvatting, trefwoorden en verwijzingen naar verwante gesprekken. Triviale chats worden overgeslagen.
- Compileren tot kennis. Komt een onderwerp in meerdere gesprekken terug, dan wordt het een wiki-pagina die de lessen samenvat in mijn eigen woorden, met links terug naar de bron.
Alles staat in Obsidian, een notitie-app die alles als gewone tekstbestanden op mijn laptop bewaart. Dankzij de onderlinge links ontstaat vanzelf een kaart: je ziet niet alleen welke gesprekken bij elkaar horen, maar ook welke projecten eruit voortkwamen.
Bewust geen zware machinerie. Ik heb geen krachtige computer die een lokaal AI-model kan draaien, en dat blijkt ook niet nodig. Het hele systeem is platte tekst: doorzoekbaar met simpele middelen, en het draait op een gewone laptop.
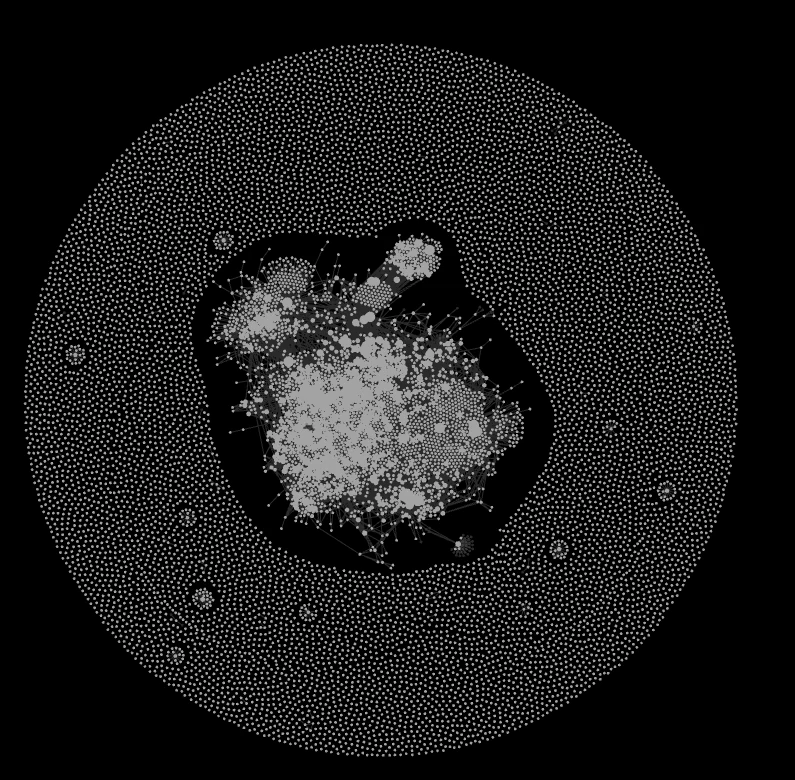
De kennisbank in Obsidian. De dichte kern is de gecompileerde, onderling gelinkte kennis. De buitenring zijn losse gesprekken die nog op een verbinding wachten.
Wat er brak
Waar het schuurde
Een pijplijn tekenen is makkelijk. Ruim drie jaar rommelige export er doorheen duwen is dat niet. Drie dingen kostten de meeste moeite.
De omvang. Alleen de Grok-export al was 730 MB. Alles in één keer verwerken liep vast, dus het gebeurt in blokken, met een logboek zodat een crash niet betekent dat je opnieuw begint.
Dubbelingen. Sommige platforms exporteren telkens je hele geschiedenis opnieuw, ook wat al binnen was. Blind opnieuw verwerken zou het archief vol duplicaten zetten. De oplossing is een controle op een uniek kenmerk per gesprek: al bekend en ongewijzigd wordt overgeslagen, een nieuwere versie overschrijft de oude, alleen echt nieuwe gesprekken komen erbij.
Privacy. Dit is mijn geschiedenis, met alles wat daar per ongeluk in staat. E-mailadressen, telefoonnummers en geplakte toegangscodes worden er automatisch uitgehaald, en het ruwe archief blijft bewust op mijn laptop in plaats van in de cloud.
Persoonsgegevens gaan eruit voordat er iets wordt opgeslagen.
Het resultaat
Wat het oplevert
Het staat er, en het groeit met elke nieuwe export mee.
Stand 2 oktober 2026. Het archief groeit met elke nieuwe export, en wordt bij binnenkomst meteen opgeschoond.
Belangrijker dan de aantallen is wat het mogelijk maakt. Ik kan nu een vraag stellen als "wat had ik ook alweer uitgezocht over die ene aanpak" en meteen de plek terugvinden waar het is opgelost, met de bron erbij. En dit archief is de voedingsbodem geworden voor Kai, mijn AI-assistent: die put uit dezelfde kennisbank in plaats van elke keer opnieuw te beginnen.
Lenen en verwerpen
Overnemen is ook nee zeggen
Het systeem draaide al een paar maanden toen Garry Tan, de baas van startup-broedplaats Y Combinator, in augustus 2026 zijn eigen tweede brein compleet als open bron online zette. Er lag ineens een volledig uitgewerkt voorbeeld op tafel: een systeem dat 's nachts automatisch bijwerkt, op meerdere manieren tegelijk doorzoekbaar is, en een kaart van verbanden om alle notities heen legt. Verleidelijk om dat in zijn geheel over te nemen. Dat heb ik niet gedaan.
Ik heb per onderdeel eerst gemeten of ik het nodig had. Twee voorbeelden: een ja en een nee.
- Wél overgenomen: automatisch bijwerken bij binnenkomst. Zodra ik een nieuwe export inlees, worden verse gesprekken meteen samengevat en aan de rest gekoppeld, zonder dat ik er nog iets voor hoef te doen. Maar bewust niet elke nacht op de klok. Ik heb geteld hoe vaak er echt nieuw materiaal binnenkomt, en dat bleek zo zelden dat een nachtelijke ronde vrijwel altijd voor niets zou draaien. Dus gebeurt het op het enige moment dat telt: bij het inlezen zelf.
- Niet overgenomen: een permanent draaiend opschoonsysteem. Ik heb in augustus 2026 apart geteld hoeveel echte dubbelingen er in mijn archief zaten, en dat viel mee: vijf, op ruim dertienhonderd gesprekken. Zware machinerie optuigen voor zo weinig winst is de verkeerde ruil. Ik heb de vijf letterlijke dubbelingen opgeruimd en het daarbij gelaten.
Zo ging het met elk onderdeel dat ik van anderen leende: eerst meten wat het bij mij oplevert, dan pas overnemen.
De eerlijke keerzijde
Nooit helemaal af
Het ruwe archief loopt bij tot de laatste export. De samenvattingen per onderwerp lopen altijd achter: er zijn steeds onderwerpen die nog wachten op een goede samenvatting.
De belangrijkste les zit in het terugzoeken. Een AI die antwoordt uit zijn geheugen in plaats van uit de bron, verzint dingen. Daarom geldt hier een harde regel: eerst de passage letterlijk terugvinden, dan pas antwoorden. En "dat staat er niet" is een geldig antwoord.
Bronnen & inspiratie
Waar het idee vandaan komt
Dit project staat op de schouders van drie mensen, in twee etappes. Aan het begin stonden Andrej Karpathy, met zijn idee om je eigen kennis als een doorzoekbare wiki te bewaren, en Charlie Hills, die liet zien hoe je daar met AI een tweede brein van bouwt dat met je meegroeit. Op die twee is dit in mei 2026 gebouwd. Daarna kwam Garry Tan, die in augustus 2026 zijn eigen versie compleet als open bron deelde en zo liet zien hoe ver je zo'n systeem kunt doortrekken; zijn onderdelen zijn stuk voor stuk gemeten tegen wat er al draaide.
→ Andrej Karpathy - LLM-powered personal knowledge base (GitHub)
→ Charlie Hills - How I built a 2nd brain with AI (Substack)
→ Garry Tan - GBrain, een open-source tweede brein (GitHub)
Het beeld bovenaan deze pagina is AI-gegenereerd (halftone paper-collage). Meer van mijn AI-beeldwerk staat in de galerij.
Verwant werk
Meer uit dit systeem
Dit geheugen staat niet op zichzelf: het voedt en wordt gevoed.